Fábrica: do pedido ao sistema verificado
Skills do Claude Code que levam um PEDIDO.md a um sistema rodando, e quem aprova cada etapa é um script, não o agente.
Resultados
5/5
pedidos com 100% dos critérios de aceite, 4 deles inéditos
de 17/17 a 31/31 critérios por pedido
medidoout/2026execuções pelo caminho da banca, conferidas com fabrica verificar
~30 min
do PEDIDO.md ao sistema verificado, sem intervenção humana
27 a 31 min nas 5 execuções
medidoout/2026logs das execuções headless
0
voltas de gate nas 5 execuções finais
medidorelatórios gerados pelo pacote
513
testes do próprio pacote, 0 falhas no Windows e no Linux
medidosuíte de testes do repositório
Resumo
Contexto
No Hackathon Ideen 2026, o desafio era levar um pedido em linguagem natural até um sistema funcionando, com concepção, especificação, construção e revisão de verdade, e com evidência que outra pessoa conseguisse conferir. Sozinho, um agente de código tende a pular etapas, escrever testes que só confirmam o próprio código e declarar sucesso sem prova.
Ação
Construí sozinho, em três dias, um pacote de skills para o Claude Code com nove papéis em subagentes de contexto limpo: PM, Arquiteto, Conselho, QA, Dev, três revisores e Retro. Cada etapa termina num gate decidido por um script em Node, e não pelo modelo. O QA escreve e sela por hash os testes de aceite antes do código, a revisão roda quatro ferramentas de segurança e as evidências são geradas a partir dos próprios artefatos.
Resultado
Pelo caminho exato da banca (claude -p numa pasta limpa), cinco pedidos, quatro deles inéditos, passaram com 100% dos critérios, de 17/17 a 31/31, em 27 a 31 minutos cada e sem nenhuma volta de gate. Antes disso, 12 execuções por subagente somaram 339/339 critérios. O pacote tem 513 testes próprios.
Lição
Confiabilidade em agentes vem de tirar do modelo a decisão de que o trabalho terminou: quem aprova precisa ser determinístico e externo.
Arquitetura
Versão longa
O problema
O kit do hackathon pedia uma coisa simples de dizer e difícil de fazer: receber um PEDIDO.md e
entregar um sistema que outra pessoa consiga verificar. A falha típica de um agente não é
escrever código ruim. É dizer que terminou quando não terminou, ou escrever testes moldados ao que
ele mesmo implementou.
As decisões
1. Quem aprova é um script. Cada etapa (Concepção, Especificação, Construção, Revisão) termina
num gate executado por fabrica.mjs, um CLI em Node sem dependências. Um gate reprovado devolve o
trabalho ao papel responsável, e na terceira volta a etapa fica bloqueada. O agente não tem como
"achar" que passou.
2. Testes selados antes do código. O QA escreve os testes de aceite a partir da spec e grava o hash deles. Se o Dev altera um teste, o gate reprova. Quando um teste contradiz a spec, existe um caminho formal: o Dev contesta e o QA decide e sela de novo, com o motivo registrado.
3. Um papel por contexto. São nove papéis, cada um num subagente com contexto limpo e um "cartão" de instruções. O revisor de segurança não carrega o viés de quem escreveu o código.
4. Revisão em três lentes. Qualidade, aderência ao pedido e segurança, essa última com bandit, pip-audit, detect-secrets e semgrep. Um achado de severidade alta ou média ainda aberto reprova o gate final.
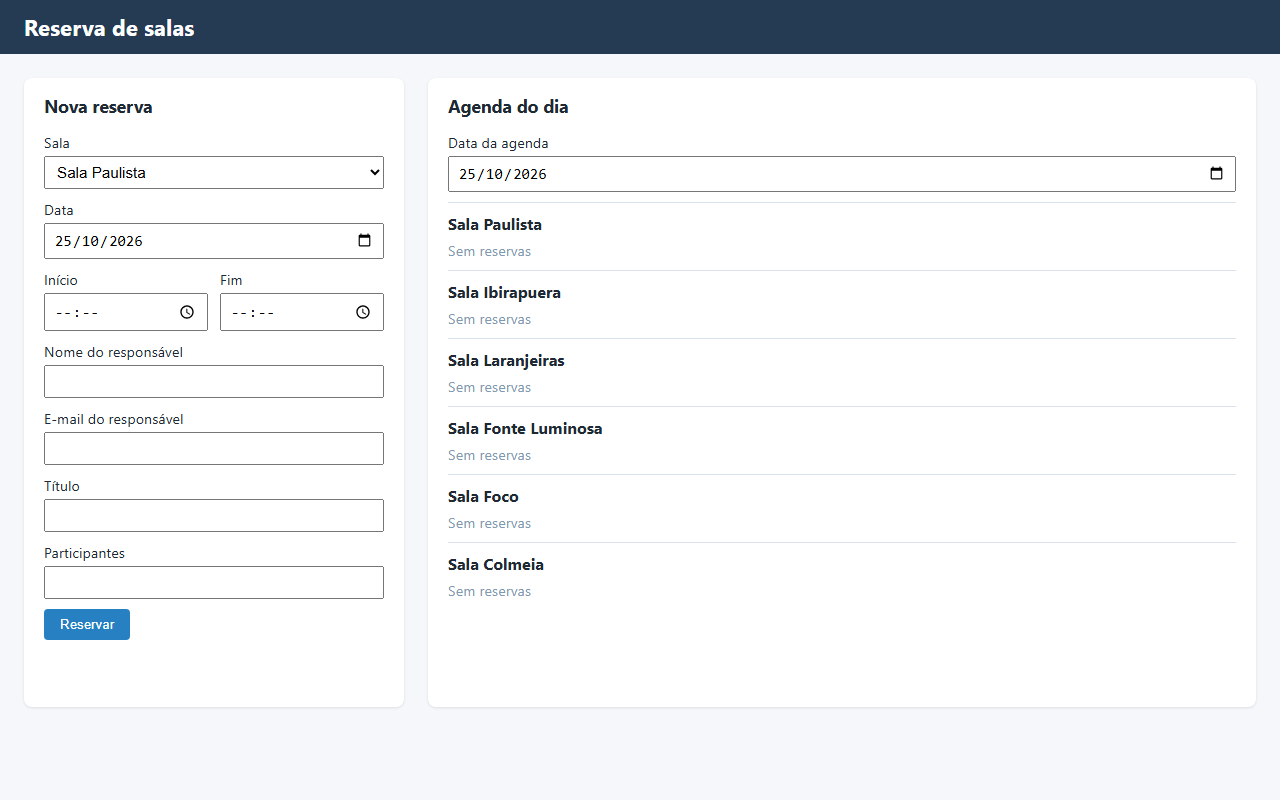
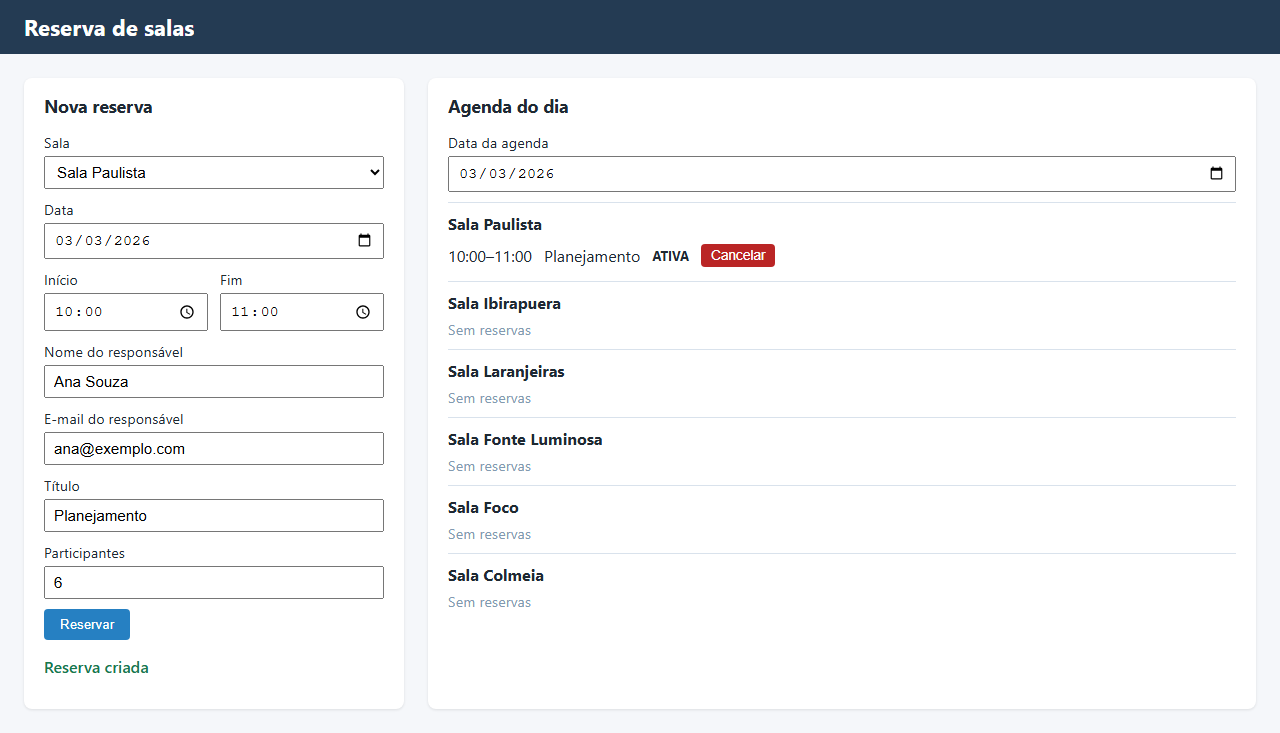
5. Evidência gerada, não declarada. O relatório liga critério → teste → resultado, e a retro lista os erros da execução. Há também um painel offline e prints das telas com dados, como os abaixo.
Como medi
Medi pelo caminho exato que a banca usaria: claude -p com o prompt do kit, numa pasta limpa só com
o PEDIDO.md e as skills, sem nenhum ajuste manual. A conferência foi feita depois, por fora do
agente.
| Pedido | Critérios do pedido | Total (com derivados) | Gates | Duração | |---|---|---|---|---| | Treino: reserva de salas | 10/10 | 19/19 | 4, sem voltas | 31 min | | Inédito: visitantes na portaria | 10/10 | 22/22 | 4, sem voltas | 27 min | | Inédito: manutenção preventiva (critérios só em prosa) | 7 → 7 | 17/17 | 4, sem voltas | 28 min | | Inédito: escala de plantão (regras cruzadas) | 10/10 | 23/23 | 4, sem voltas | 31 min | | Inédito: despesas de viagem (escopo maior) | 12/12 | 31/31 | 4, sem voltas | 31 min |
Os critérios derivados são escritos pelo Arquiteto a partir das regras do pedido: bordas, validações e a tela.
Onde a IA errou
Registrei 31 erros. Quatro deles mudaram o pacote:
| Erro | O que mudou |
|---|---|
| Um subagente travou por falha da API e o orquestrador parou para perguntar ao usuário | Modo autônomo que nunca pergunta; o subagente é reaberto até 2 vezes, continuando do disco |
| Dois revisores ficaram 13 min presos numa trava de arquivo, porque no Node do Windows o rmSync não apagava caminho com acento e não dava erro | Remoção com alternativa em todo o pacote e espera de trava com prazo |
| Um taskkill /IM python.exe derrubou todo Python da máquina | Matar processo por nome ficou proibido; o encerramento usa o PID gravado |
| O Dev mudou código na revisão sem achado, e o código novo não foi varrido | O gate final reprova código alterado depois da varredura de segurança |
Como se compara
Comparei a documentação de 19 projetos públicos parecidos, entre eles Spec Kit, BMAD, Kiro, superpowers e Taskmaster. A Fábrica é a única que junta gate decidido por script, testes imutáveis antes do código, papel por contexto isolado, segurança com ferramentas e pedido → sistema sem humano. Em troca, eles suportam várias linguagens e projetos existentes; a Fábrica validou um perfil (web em Python) para sistemas novos.
Limitações
- Caminho da banca medido com 5 pedidos, só no Windows e com um único modelo. Uma sexta execução parou no meio e está registrada junto com a correção.
- Um perfil validado (FastAPI, SQLite e tela HTML/JS).
- Os pedidos sintéticos foram escritos por mim.
Lições aprendidas
- Gate fora do modelo. Um script que reprova é mais confiável que um prompt pedindo rigor.
- Selar antes de construir. Com os testes de aceite selados por hash, o Dev não consegue ajustar a régua ao próprio código.
- O log de erros é o roadmap. Documentei 31 erros da IA durante o projeto, e cada um virou uma regra do pacote.